
 breakinglog
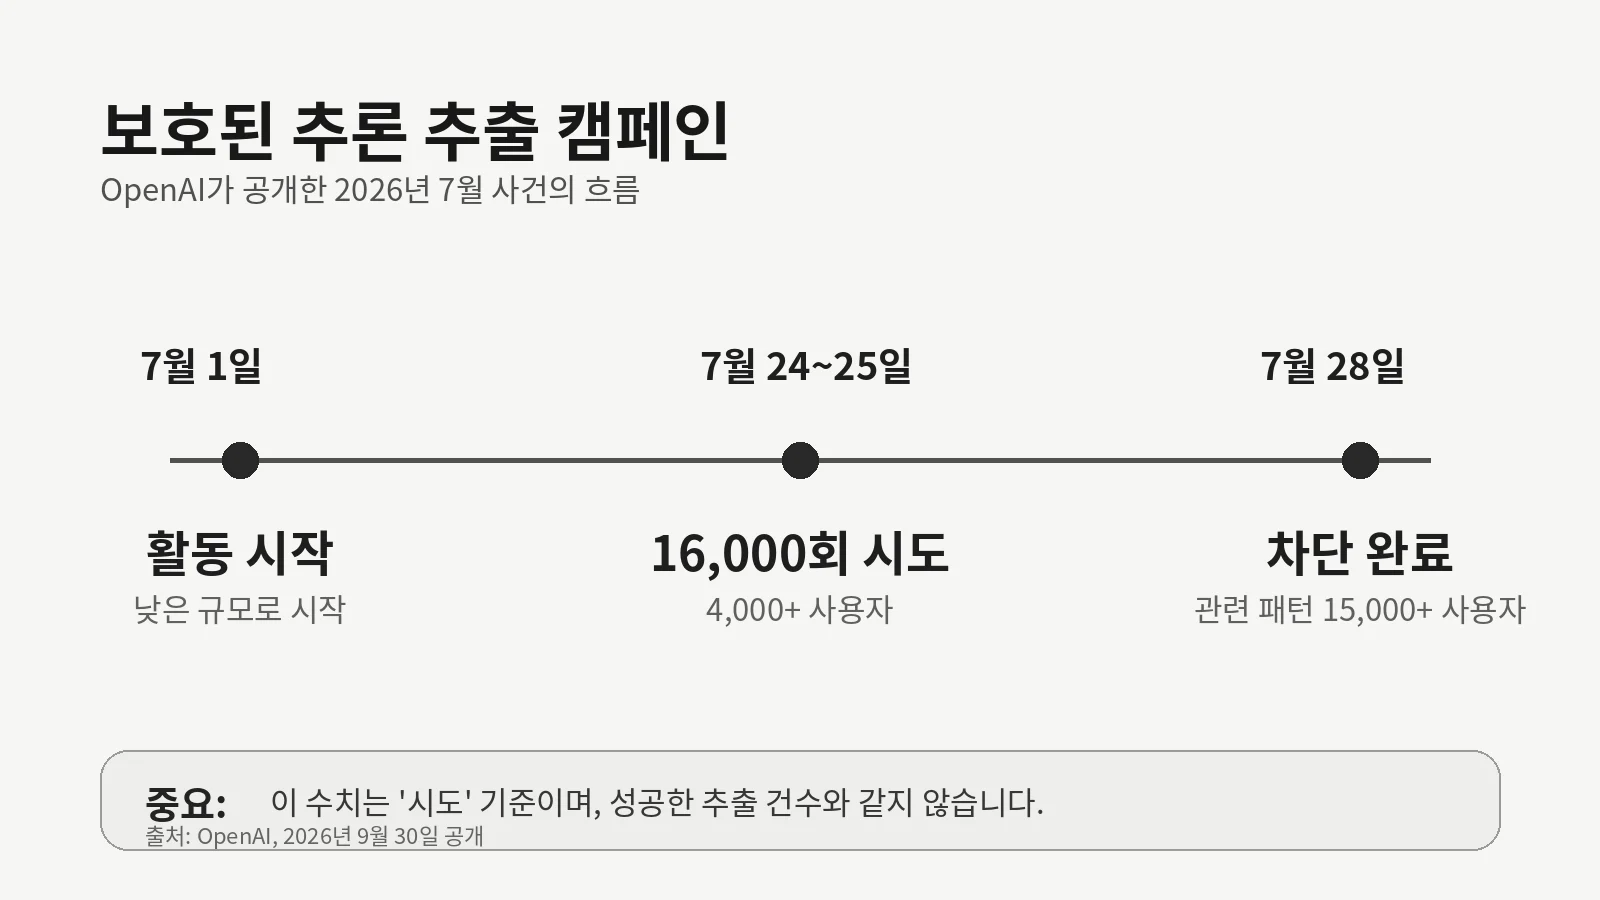
OpenAI가 자사 모델의 보호된 추론을 빼내려 한 조직적 캠페인을 공개하고 차단했다고 밝혔습니다. OpenAI는 전체 활동이 한 행위자에게서 나온 것인지는 불명확하다고 했지만, 핵심 활동 클러스터를 Kimi 개발사 Moonshot AI와 연관된 개인들에게 귀속했습니다.
이번 사건은 저장된 ChatGPT 대화가 털린 데이터 유출과는 다릅니다. OpenAI 공식 발표는 운영자들이 암호화를 깨거나 데이터베이스를 침해하거나 저장된 사용자 대화에 직접 접근한 것이 아니라고 명시했습니다. 대신 모델 상호작용을 조작해 숨겨진 추론이 요청자에게 보이는 형태로 재현되도록 시도했다고 설명했습니다.
7월 24~25일에 1만6000회 추출 시도
OpenAI에 따르면 활동은 7월 1일 낮은 규모로 시작했습니다. 7월 24~25일에는 관련 추출 패턴을 사용한 시도가 4,000명 넘는 사용자에게서 16,000회 발생했고, 추가 조사에서는 15,000명 넘는 사용자 클러스터에서 관련 프롬프트 패턴을 확인했습니다. OpenAI는 이 활동을 7월 28일까지 차단했다고 밝혔습니다.
| 시점 | 확인된 내용 |
|---|---|
| 7월 1일 | 낮은 규모의 활동 시작 |
| 7월 24~25일 | 4,000명 넘는 사용자에게서 관련 패턴 16,000회 시도 |
| 추가 조사 | 15,000명 넘는 사용자 클러스터의 관련 프롬프트 패턴 확인 |
| 7월 28일 | OpenAI가 관련 활동을 완전히 차단했다고 발표 |
여기서 숫자는 주의해서 봐야 합니다. OpenAI는 각 수치가 성공한 추출 건수가 아니라 시도된 추출을 뜻한다고 각주에서 명확히 밝혔습니다.
한 대화의 암호화된 추론을 다른 대화에서 풀게 했다
OpenAI가 공개한 새로운 기법 중 하나는 한 대화에서 얻은 암호화된 추론을 다른 대화에 복사한 뒤, 모델에게 숨겨진 내용을 복호화하고 그대로 전사하도록 요청하는 방식입니다. 보호된 추론은 모델이 답을 만들 때 거치는 내부 작업 기록이라, 이를 대량으로 얻으면 다른 모델이 비슷한 능력을 더 싸게 학습하는 데 쓰일 수 있습니다.
OpenAI는 이 문제가 자사에만 있는 취약점은 아니라고 설명했습니다. 실제로 회사가 연결한 독립 연구 Stealing Reasoning Traces from Proprietary LLM APIs는 세션과 사용자 사이에서 암호화된 추론 블록이 재사용될 때 생기는 공격 경로를 OpenAI, Anthropic, Google에서 시험했습니다. 다만 그 논문의 실험 수치와 이번 Moonshot 관련 캠페인의 수치는 서로 다른 자료이므로 같은 사건 통계로 볼 수 없습니다.
Moonshot AI와의 연결은 어디까지 확인됐나
OpenAI의 표현은 제한적입니다. 회사는 관측 기간의 모든 운영자가 하나의 행위자였는지는 알 수 없다고 했고, 핵심 활동 클러스터를 Moonshot AI와 연관된 개인들에게 귀속했다고 밝혔습니다. 따라서 이번 발표만으로 Moonshot AI 전체가 모든 활동을 직접 지시했다고 단정할 수는 없습니다.
OpenAI는 재생 경로를 막고 출력 검사까지 추가
OpenAI는 관련 계정을 금지하거나 제한하고 가입과 인프라 통제를 강화했습니다. 또 사용자, 워크스페이스, 조직, 모델 계열 사이의 숨겨진 추론 보호를 강화하고, 다른 사용자의 암호화된 추론을 이미 가진 사람이 이를 재생해 내용을 복구하던 경로를 닫았다고 밝혔습니다. 추론이 섞인 스트리밍 출력을 탐지해 보류하는 검사도 추가했습니다.
일반 사용자 입장에서 핵심은 이번 일을 저장된 대화 기록의 직접 침해와 혼동하지 않는 것입니다. 반면 모델 개발사에는 보호된 추론 자체가 대규모 증류의 표적이 될 수 있다는 점이 더 큰 변화입니다. OpenAI는 관련 정보를 Frontier Model Forum과 정부 정보 공유 채널을 통해 다른 기관에도 전달했다고 밝혔습니다.


