
 breakinglog
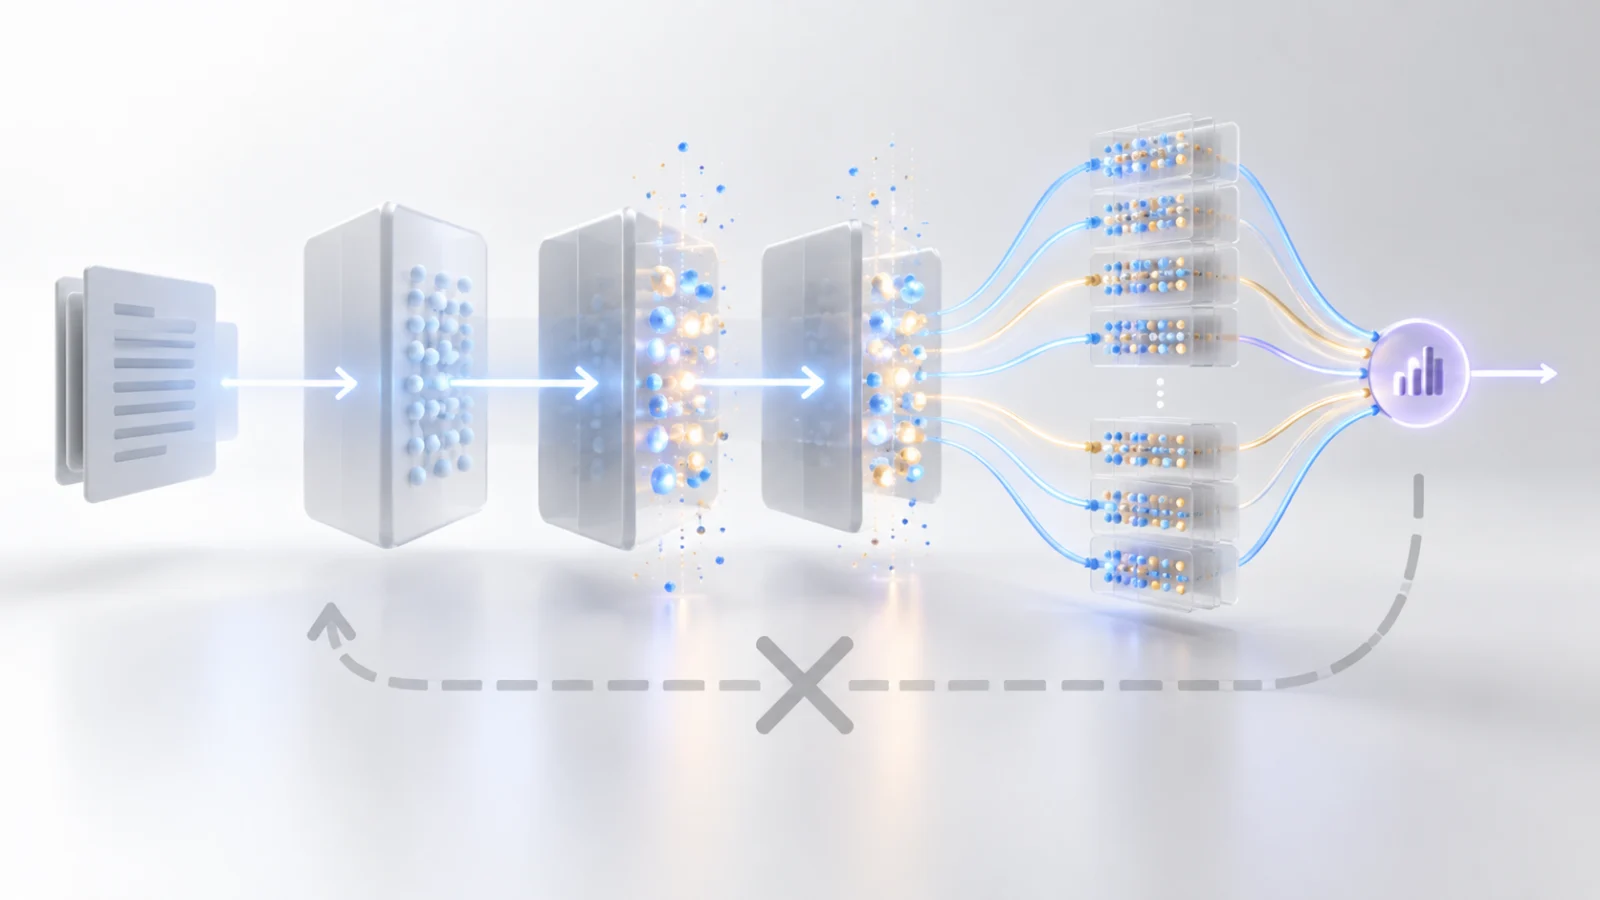
Q Labs가 역전파(backpropagation)를 쓰지 않고 트랜스포머 언어모델을 처음부터 사전학습하는 새 방법 ‘Dust’를 공개했습니다. 연구진은 활성값에 작은 잡음을 넣고, 그 변화가 손실을 얼마나 낮췄는지 반복 측정해 학습 신호를 추정합니다. 작은 규모와 중간 규모 실험에서는 충분히 많은 반복 계산을 쓸 때 역전파에 가까워지거나 일부 조건에서 더 낮은 손실을 기록했다고 보고했습니다.
다만 지금 당장 역전파를 대체하는 기술은 아닙니다. 연구진 스스로 현재 계산량 기준에서는 실용적 대안이 되려면 계산 효율이 몇 자릿수 더 좋아져야 한다고 명시했습니다. 현재 결과는 Q Labs가 공개한 자체 실험이며, 독립적인 재현 결과는 아직 확인되지 않았습니다.
역전파 대신 ‘흔들어 보고 결과를 측정’합니다
일반적인 딥러닝 학습은 출력 오차를 역방향으로 전달해 각 가중치가 어느 방향으로 움직여야 하는지 미분으로 계산합니다. Dust 연구는 이 역방향 계산 대신 각 층의 활성값에 가우시안 잡음을 넣고, 잡음을 넣었을 때 토큰 손실이 어떻게 변했는지로 오차 방향을 추정합니다.
핵심은 토큰마다 서로 다른 잡음을 넣는 방식입니다. 연구진은 각 토큰을 하나의 ‘가상 개체’처럼 취급해 한 번의 순전파 안에서 많은 후보를 동시에 평가합니다. 가중치 자체를 여러 벌 복제해 흔드는 기존 진화전략보다 같은 순전파에서 훨씬 큰 탐색 집단을 만들 수 있다는 설명입니다.
FineWeb에서 10만~2천만 토큰 규모로 비교했습니다
연구진은 FineWeb 데이터로 GPT 계열 트랜스포머를 학습했습니다. 기본 모델은 8개 층, 폭 512이며 배치는 1만6천 토큰입니다. 토큰 예산은 10만에서 2천만까지, Dust의 반복 집단은 64회에서 1만6384회까지 바꿔가며 역전파와 비교했고 각 조건은 3개 시드로 평가했습니다.
| 항목 | 연구진이 시험한 범위 | 해석할 때 주의점 |
|---|---|---|
| 학습 데이터 | FineWeb, 10만~2천만 토큰 | 현대 프론티어 모델의 전체 사전학습 규모와는 다름 |
| 기본 모델 | 8층, 폭 512 | 별도 크기 실험은 최대 2억4300만 파라미터 |
| Dust 집단 크기 | 64~1만6384 draws | 집단이 커질수록 계산량도 크게 증가 |
| 비교 기준 | 동일 프로토콜의 역전파와 EGGROLL | 결과는 연구진 자체 구현과 튜닝 조건 기준 |
작은 예산에서는 역전파를 넘었지만, 큰 예산은 아직 ‘격차 축소’ 단계입니다
저자들의 결과에서는 10만과 100만 토큰 조건에서 충분히 큰 집단을 쓴 Dust가 역전파보다 낮은 최종 손실을 기록한 조건이 있었습니다. 1천만과 2천만 토큰으로 늘리면 집단이 커질수록 역전파와의 차이가 줄어들었습니다.
특히 2천만 토큰 결과에서 연구진은 집단 크기를 무한대로 늘렸을 때의 손실을 4.431로 추정했고 역전파는 4.633이었습니다. 하지만 이 4.431은 실제로 측정한 결과가 아니라 여전히 내려가고 있는 실험 곡선에 맞춘 외삽값입니다. 연구진도 이를 “Dust가 역전파를 확실히 이겼다”는 측정값이 아니라, 반복 계산을 늘릴수록 격차가 계속 좁아진다는 증거로 해석한다고 적었습니다.
모델이 커지면 오히려 탐색이 무너질 것이라는 예상과 다른 결과도 나왔습니다
연구진은 1천만 토큰 조건에서 약 200만, 730만, 3800만, 2억4300만 파라미터 모델도 비교했습니다. 보고서에 따르면 큰 모델이 작은 모델보다 반복 집단을 더 효과적으로 활용했고, 2억4300만 파라미터 모델은 대부분의 집단 크기에서 120배 작은 모델보다 더 나은 결과를 냈습니다.
또 이미 역전파로 학습된 체크포인트에서 Dust가 추정한 학습 방향과 실제 역전파 gradient의 코사인 유사도를 비교했을 때, 집단 크기가 커질수록 정렬이 좋아졌고 최대 10억 토큰 학습 체크포인트까지 이 경향이 유지됐다고 보고했습니다. 이 역시 저자들의 실험 결과이며 더 큰 규모에서 그대로 유지되는지는 별도 검증이 필요합니다.
코드는 공개됐지만, 기본 재현도 계산 자원이 큽니다
공개 코드 저장소는 MIT 라이선스이며 Linux, Python 3.10 이상과 bfloat16을 지원하는 NVIDIA GPU를 요구합니다. 논문 설정의 기본 집단 1만6384회 실행은 8개 GPU를 사용하고, 저장소는 단일 GPU에서 집단 256으로 줄인 작은 실행 방법도 제공합니다.
저장소의 구현은 연구의 핵심 estimator와 튜닝 기본값을 보존한 최소 구현이며, 전체 실험에 사용한 실행 최적화는 생략됐다고 설명합니다. 따라서 코드를 실행할 수 있다는 사실과 논문의 모든 수치를 같은 비용으로 재현할 수 있다는 의미는 구분해야 합니다.
왜 중요한가: ‘미분 가능한 구조’라는 제약을 줄일 가능성입니다
Dust가 실용화된다면 의미는 단순히 역전파를 다른 공식으로 바꾸는 데 그치지 않습니다. 역전파는 계산 그래프가 미분 가능해야 하고 긴 반복 구조에서는 메모리와 안정성 제약이 생깁니다. 저자들은 검색 기반 학습이 발전하면 외부 프로그램이 중간에 들어가거나 매우 긴 반복을 쓰는 구조처럼 기존 역전파가 다루기 어려운 모델을 학습하는 길이 열릴 수 있다고 봅니다.
하지만 현재 단계에서 가장 중요한 숫자는 성능보다 추가 계산량입니다. Q Labs는 Dust가 가중치 공간 진화전략보다 훨씬 효율적이라고 보고하면서도, 현재 컴퓨팅 환경에서 역전파를 대체하려면 여전히 계산 효율이 몇 자릿수 더 개선돼야 한다고 명시했습니다. 지금은 “역전파가 끝났다”기보다 트랜스포머 사전학습에서도 순전파 기반 검색이 생각보다 멀리 갈 수 있다는 초기 실험으로 보는 편이 정확합니다.


