
 breakinglog
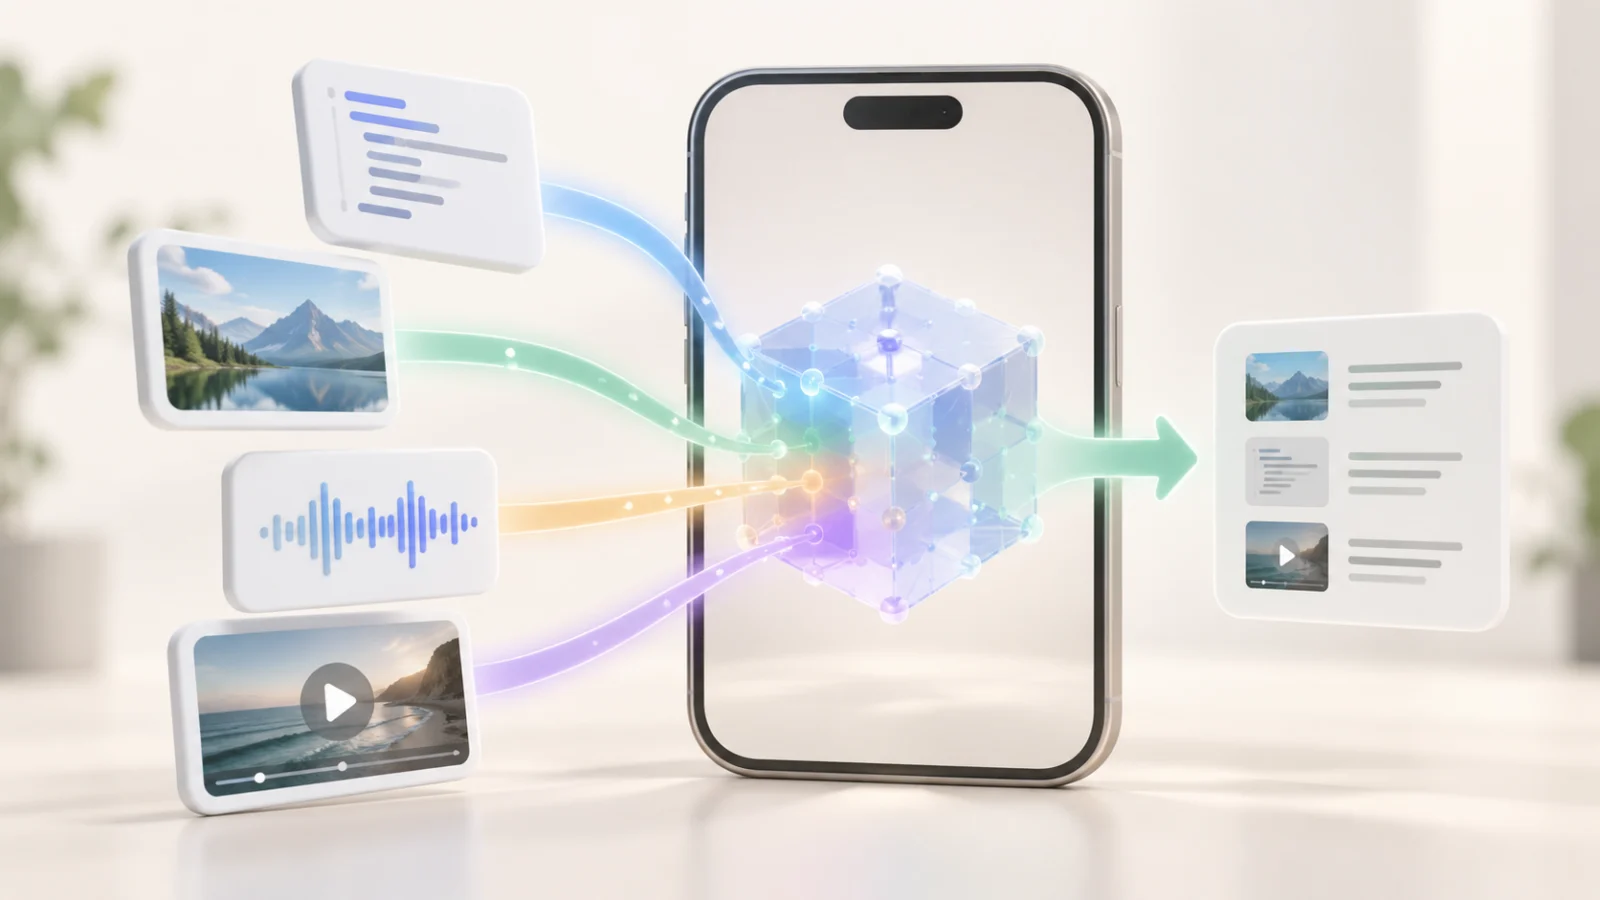
Google DeepMind가 10월 6일 텍스트뿐 아니라 코드, 이미지, 영상, 오디오를 한꺼번에 검색할 수 있는 오픈 웨이트 임베딩 모델 EmbeddingGemma 2를 공개했습니다. 모든 기능을 쓰는 구성은 7억4천만 매개변수이고, 텍스트와 코드만 필요하면 2억7천만 매개변수 구성만 불러올 수 있습니다.
중요한 차이는 이 모델이 답변을 생성하는 챗봇이 아니라 서로 다른 자료를 같은 의미 공간의 벡터로 바꿔 검색, RAG에 쓰는 모델이라는 점입니다. Google은 기기 안에서 실행하는 검색을 주요 용도로 설계했으며, 공식 개발자 가이드는 Apache 2.0 라이선스와 768차원 공통 임베딩 공간을 안내합니다.
텍스트 전용 3.08억에서, 7.4억 멀티모달로 넓어졌습니다
2025년 공개된 첫 EmbeddingGemma는 3억800만 매개변수의 텍스트 중심 모델이었습니다. 이번 EmbeddingGemma 2는 기반을 Gemma 4로 옮기고 텍스트, 코드, 이미지, 영상 프레임, 오디오를 같은 768차원 공간에 넣도록 확장했습니다.
| 불러오는 입력 | 매개변수 | 주요 용도 |
|---|---|---|
| 텍스트, 코드 | 270M | 문서, 코드 검색 |
| 텍스트, 코드+비전 | 440M | 이미지, 문서, 영상 프레임 검색 |
| 텍스트, 코드+오디오 | 570M | 음성, 소리 검색 |
| 전체 멀티모달 | 740M | 텍스트, 코드, 이미지, 영상, 오디오 통합 검색 |
여기서 270M, 440M, 570M, 740M은 서로 다른 체크포인트를 따로 받는다는 뜻이 아닙니다. Google 개발자 가이드에 따르면 같은 체크포인트에서 필요한 인코더만 골라 불러오며, 이미 만든 텍스트 임베딩도 나중에 이미지나 오디오 인코더를 추가했다고 다시 계산할 필요가 없습니다.
휴대전화 안에서 사진과 음성까지 같이 찾는 것이 목표입니다
Google AI Edge 팀의 설명에서 제시한 핵심 용도는 로컬 검색입니다. 예를 들어 텍스트로 사진을 찾거나, 음성 메모와 영상 프레임을 같은 검색 색인에 넣어 관련 자료를 찾는 식입니다. 각각을 캡션, 음성인식, 텍스트 임베딩 모델로 이어 붙이는 대신 하나의 공통 벡터 공간을 사용할 수 있습니다.
Google이 Pixel 11 Pro에서 측정한 수치로는 텍스트 전용 가중치의 활성 RAM이 약 191MB, 전체 멀티모달 구성이 약 567MB였습니다. 이는 Google의 해당 기기 측정값이지 모든 휴대전화에서 동일한 메모리 사용량을 보장하는 수치는 아닙니다.
8192토큰 입력, 벡터는 768차원에서 128차원까지 줄일 수 있습니다
텍스트, 코드 기반부는 8,192토큰 컨텍스트를 사용합니다. 출력 임베딩은 기본 768차원이지만 Matryoshka Representation Learning(MRL)을 이용해 512, 256, 128차원으로 줄일 수 있습니다.
공식 가이드는 bfloat16 기준 100만개의 768차원 벡터 저장에 약 1.5GB, 128차원에는 약 250MB가 필요하다고 예시합니다. 즉 저장 공간은 약 6분의 1로 줄지만 검색 품질도 같이 떨어질 수 있습니다. Google의 안내에서는 256차원이 텍스트, 코드 품질 대부분과 이미지, 영상, 음성 검색 품질 약 95%를 유지했고, 128차원에서는 멀티모달 검색 품질 저하가 더 컸기 때문에 실제 데이터로 검증하라고 권고합니다.
Gemini Embedding 2와는 역할과 실행 위치가 다릅니다
이름이 비슷하지만 Gemini Embedding 2와 EmbeddingGemma 2는 다른 제품입니다. Gemini Embedding 2는 Gemini API, Vertex AI를 통해 제공되는 Google의 클라우드 멀티모달 임베딩 모델이고, EmbeddingGemma 2는 직접 내려받아 기기나 자체 환경에서 실행하는 소형 오픈 웨이트 모델입니다.
따라서 서버 API로 가장 큰 모델을 쓰는 대신 개인정보가 있는 사진, 음성, 문서를 외부로 보내지 않고 로컬 검색을 만들거나, 노트북, 휴대전화에서 작은 RAG 색인을 운영하려는 개발자에게 이번 변화가 더 직접적입니다.
지금 쓸 때는 필요한 인코더와 벡터 크기부터 정하면 됩니다
텍스트와 코드만 검색한다면 270M 구성부터 시작할 수 있고, 이미지나 영상 프레임이 필요하면 비전 인코더를 더해 440M, 오디오까지 모두 필요하면 740M 구성을 불러오는 식입니다. 임베딩은 모두 같은 768차원 공간을 공유하므로 용도가 늘어날 때 색인 구조를 처음부터 완전히 바꿀 필요가 없습니다.
저장 공간이 충분하면 768차원을 기준으로 시작하고, 기기 메모리나 벡터 DB 크기가 병목이면 256차원부터 실제 검색 결과를 비교하는 편이 안전합니다. 128차원은 저장량을 크게 줄일 수 있지만, 특히 이미지, 영상, 음성 검색에서는 품질 손실을 먼저 확인해야 합니다.


