
 breakinglog
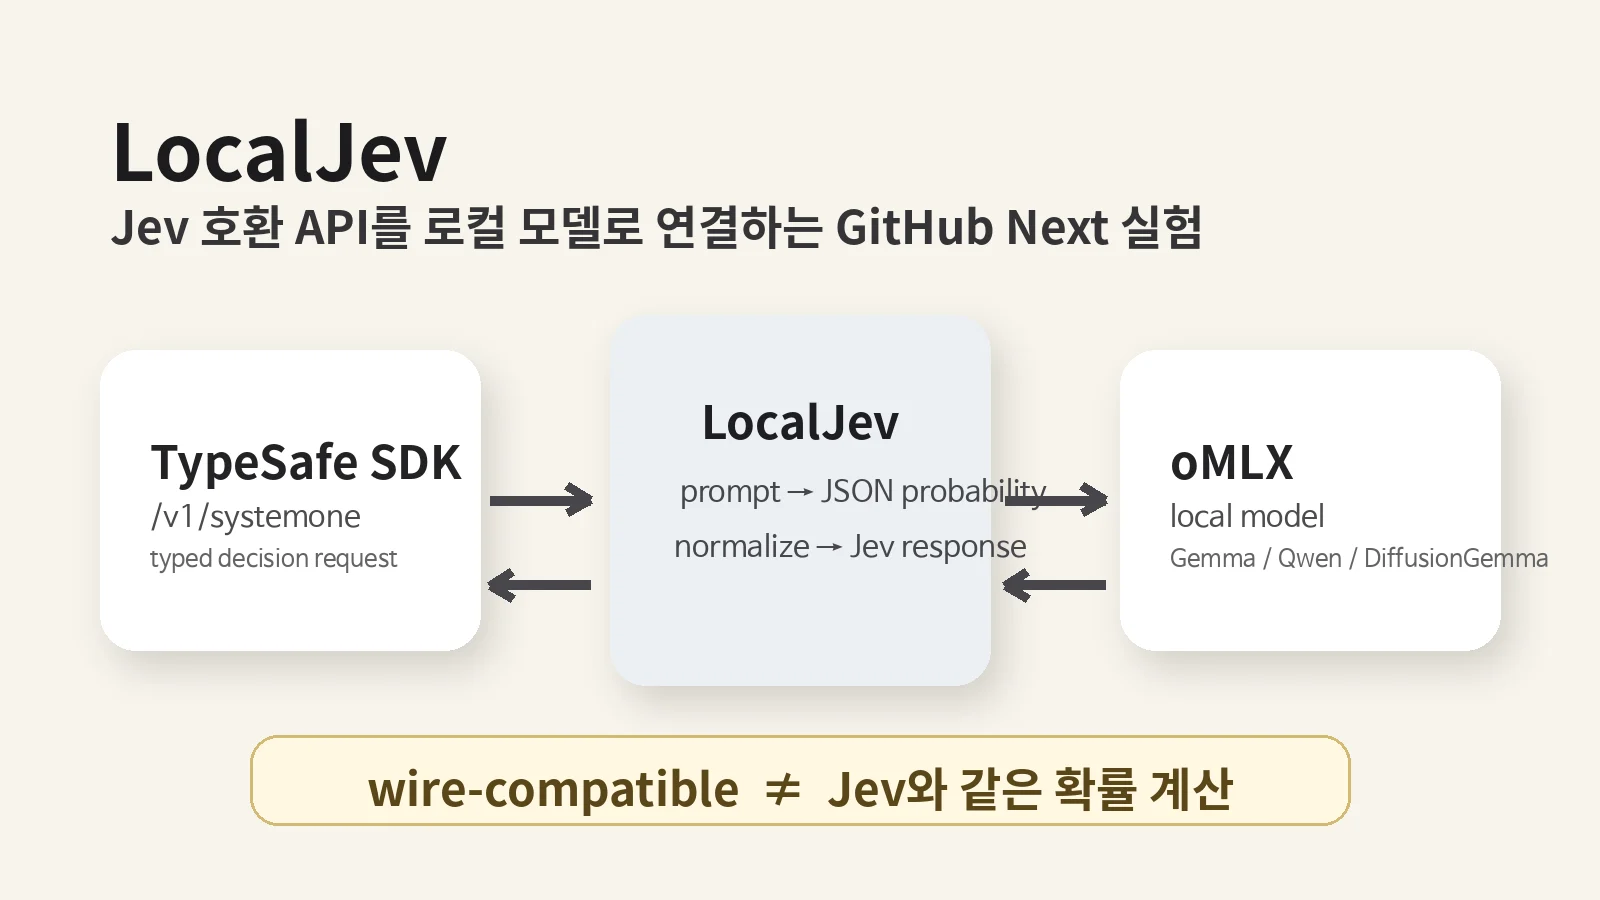
GitHub의 실험 조직인 GitHub Next 팀이 TypeSafe Jev와 같은 POST /v1/systemone 형태로 호출할 수 있는 오픈소스 서버 LocalJev를 공개했습니다. 핵심은 Jev용 SDK를 크게 바꾸지 않고 로컬 모델을 판단 엔진으로 연결하는 것입니다.
다만 “Jev를 로컬에서 그대로 돌린다”는 뜻은 아닙니다. LocalJev는 API 모양은 호환하지만, Jev 계열 구현이 모델 내부의 확률을 읽는 방식과 달리 로컬 모델에게 JSON 확률 값을 직접 쓰게 한 뒤 검증하고 정규화합니다. 프로젝트도 이 차이를 명시하고 있습니다.
저장소는 9월 18일 만들어졌고 GitHub Next는 9월 19일 자체 X 계정에서 공개했습니다. GitHub의 정식 제품 기능이라기보다 연구팀이 공개한 실험 프로젝트로 보는 편이 정확합니다. Jev 자체가 어떤 모델인지 먼저 보고 싶다면 기존 Jev 소개 글에서 구조를 확인할 수 있습니다.
가장 중요한 차이는 “확률을 어디서 얻느냐”입니다
LocalJev는 상태와 질문을 분류 프롬프트로 바꾼 뒤, DiffusionGemma나 Qwen, Gemma 같은 로컬 모델에게 확률 스칼라나 벡터를 JSON으로 생성하게 합니다. 형식이 잘못되면 재시도하고, 벡터를 정규화한 뒤 Jev 응답 형식으로 돌려줍니다.
반면 프로젝트 설명에 따르면 OpenJev는 DiffusionGemma의 특정 토큰 확률을 직접 읽는 구조를 사용합니다. 이를 위해 아직 병합되지 않은 vLLM 확장 기능이 필요하고, 일반적인 oMLX 채팅 API에는 그 기능이 없습니다.
그래서 LocalJev는 wire-compatible, 즉 Jev 클라이언트가 기대하는 요청과 응답 형식에는 맞지만 수학적으로 같은 확률 계산은 아닙니다. 저장소도 결과를 중요한 의사결정에 쓰기 전에 자기 작업 데이터로 보정 상태를 평가하라고 경고합니다.
1,200회 테스트에서는 Qwen3.6과 Gemma 4 26B가 상위권이었습니다
GitHub Next 저장소에는 Apple M5 Max 64GiB 환경에서 진행한 첫 비교 결과도 공개돼 있습니다. 5개 4비트 모델에 120개의 정답이 있는 예제를 두 가지 입력 조건으로 넣어 총 1,200회 요청을 측정했고, 전체 실행은 약 23.5분 걸렸습니다.
| 모델 | 짧은 입력 정확도 | 짧은 입력 p50 | 배경 2,048단어 추가 정확도 | 배경 추가 p50 |
|---|---|---|---|---|
| Qwen3.6-35B-A3B | 76.7% | 0.889초 | 69.2% | 1.499초 |
| Gemma 4 26B-A4B | 75.0% | 0.675초 | 69.2% | 1.750초 |
| DiffusionGemma 26B-A4B | 74.2% | 1.207초 | 65.0% | 2.050초 |
짧은 입력에서는 Qwen3.6이 세 작업을 합친 매크로 정확도 76.7%로 가장 높았고, Gemma 4 26B-A4B가 75.0%로 뒤를 이었습니다. 하지만 작성자는 두 모델의 차이가 120개 중 정답 두 개 수준이라 통계적으로 뚜렷한 승자라고 볼 근거는 없다고 적었습니다.
또 긴 입력 조건은 실제 긴 문서 작업이 아니라 관련 없는 배경 단어 2,048개를 추가한 인공적인 방해 테스트입니다. 모든 모델의 매크로 정확도가 낮아졌다는 점은 확인됐지만, 이 표만으로 모델 일반 성능 순위를 정할 수는 없습니다.
“64GB 메모리가 필요하다”는 최소 사양은 확인되지 않았습니다
이번 소재를 소개한 X 글에는 64GB 통합 메모리가 필요하다는 설명이 붙어 있었습니다. 하지만 GitHub Next 원문에서 확인되는 것은 벤치마크를 M5 Max 64GiB에서 실행했다는 사실입니다. 공식 README는 LocalJev 실행 조건으로 Bun 1.2 이상과 실행 중인 oMLX 서버를 안내하지만 최소 메모리 용량은 명시하지 않습니다.
기본 설정 모델은 diffusiongemma-26B-A4B-it-4bit이고, 실제 필요한 메모리는 어떤 체크포인트와 런타임을 쓰는지에 따라 달라질 수 있습니다. 따라서 현재 공개 자료만으로 “64GB 미만에서는 실행할 수 없다”고 단정하면 안 됩니다.
기존 Jev SDK를 로컬 주소로 돌리는 구조입니다
LocalJev의 기본 주소는 127.0.0.1:8080입니다. TypeSafe SDK에서는 TYPESAFE_BASE_URL을 이 주소로 바꾸면 되고, 서버는 jev-latest와 jev-preview 별칭도 받아들입니다.
다만 이것도 설치 없이 바로 쓰는 소비자용 앱은 아닙니다. Bun과 oMLX, 로컬 모델을 준비해야 하고, 확률 역시 모델이 생성한 값을 정규화한 것이므로 결제 승인이나 권한 부여처럼 결과가 중요한 판단에 바로 넣기 전에 자기 데이터로 검증하는 과정이 필요합니다.
LocalJev가 흥미로운 지점은 Jev의 “답변 대신 구조화된 판단” 인터페이스를 로컬 모델에도 붙일 수 있게 했다는 점입니다. 반대로 Jev와 같은 확률 엔진을 로컬에서 복제한 프로젝트는 아니라는 경계도 분명합니다.
출처: yulmu_coffee X 게시물, GitHub Next 공개 게시물, LocalJev 저장소, 공개 벤치마크 결과


