
 breakinglog
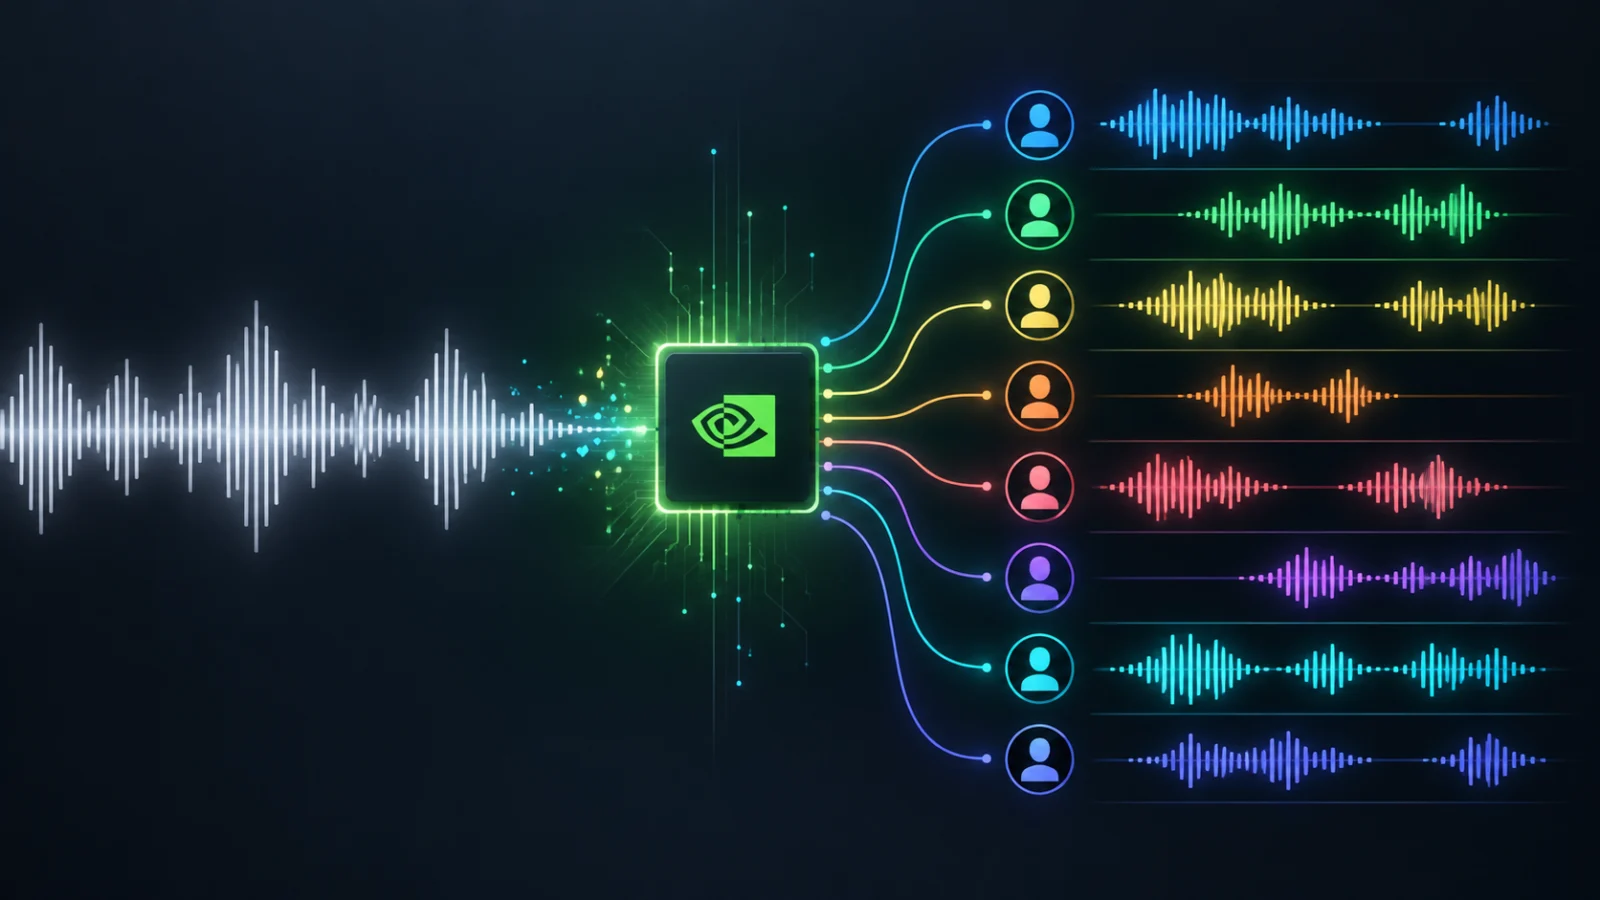
엔비디아가 9월 23일 Nemotron 3 Diarization을 공개했습니다. 엔비디아가 허깅페이스에 공개한 설명에 따르면 1억 파라미터 규모의 오픈웨이트 모델로, 실시간 또는 녹음된 오디오에서 최대 8명의 화자가 언제 말했는지 구분하고 서로 겹쳐 말하는 구간도 처리합니다. 회의, 고객 상담, 팟캐스트처럼 “무슨 말을 했는지”뿐 아니라 “누가 언제 말했는지”가 필요한 음성 작업에 직접 연결되는 변화입니다.
여기서 가장 중요한 구분이 하나 있습니다. 이 모델은 음성을 글자로 바꾸는 ASR이 아니라 화자 분리 모델입니다. 출력은 speaker_0, speaker_1 같은 익명 화자 채널과 발화 시작과 종료 시각이며, 실제 사람의 이름을 알아내지는 않습니다. 화자 이름이 붙은 최종 대화록을 만들려면 ASR 결과와 이 타임스탬프를 다시 결합해야 합니다.
기존 4명에서 최대 8명으로 늘었습니다
엔비디아의 이전 스트리밍 Sortformer 기준 모델은 최대 4명의 화자를 다뤘습니다. Nemotron 3 Diarization은 이를 8명으로 늘렸고, 하나의 체크포인트에서 오프라인 처리부터 저지연 스트리밍까지 여러 입력 버퍼 설정을 지원합니다.
| 항목 | 확인된 내용 |
|---|---|
| 모델 크기 | 100M 파라미터, 1억 개 |
| 화자 수 | 최대 8명 |
| 권장 최저 입력 버퍼 | 0.32초 |
| 입력 | 16kHz 단일 채널 음성, WAV/FLAC/OPUS/MP3 |
| 출력 | 화자별 활동 확률과 익명 화자 라벨, 시작과 종료 시각 |
0.32초라는 숫자는 앱 전체 지연시간이 아닙니다. 공식 모델 카드가 말하는 것은 모델이 한 번 추론하기 전에 기다리는 입력 버퍼 지연입니다. 모델 계산, 네트워크 전송, ASR, 이후 처리 시간은 여기에 포함되지 않습니다. 기술적으로 80ms 입력 버퍼도 가능하지만 엔비디아가 권장하는 최저 설정은 0.32초입니다.
초기 VoiceArena 평가에서는 14.72% DER로 1위였습니다
엔비디아가 공개한 VoiceArena 초기 Diarization-Bench 결과에서는 12개 시스템, 17개 설정이 약 22시간 분량의 영어 대화 139개로 평가됐고 Nemotron 3 Diarization이 14.72% DER을 기록했습니다. 다음 순위 시스템은 19.3%였습니다. DER은 말한 구간을 놓친 오류, 말하지 않은 구간을 잡은 오류, 화자를 잘못 배정한 오류를 합쳐 보는 지표로 낮을수록 좋습니다.
엔비디아의 이전 4화자 Streaming Sortformer와 같은 1.04초 입력 버퍼 조건으로 비교한 8개 평가 조건에서는 상대 DER 감소폭이 9.0%에서 65.2%였고, 조건별 상대 개선율의 단순 평균은 41.0%였습니다. 다만 VoiceArena 결과는 아직 초기 버전이며, 공식 글도 최종 평가와 통계 분석이 끝나면 순위나 수치가 바뀔 수 있다고 명시합니다.
“누구인지”가 아니라 “같은 화자인지”를 추적합니다
최대 8명 지원을 사람 식별 기능으로 받아들이면 안 됩니다. 모델은 첫 번째로 등장한 목소리를 speaker_0, 다음 새 목소리를 speaker_1처럼 일관된 채널에 배정해 대화가 이어지는 동안 같은 화자를 추적합니다. 실제 이름이나 신원을 붙이려면 회의 참가자 정보나 별도의 화자 검증 시스템이 필요합니다.
공식 모델 카드는 OpenMDW 1.1 라이선스와 상업/비상업 사용 가능 상태를 표시하고 있으며, NeMo와 Transformers 사용 예제를 제공합니다. 공식 지원 환경은 Linux와 엔비디아 GPU 가속 시스템입니다. 따라서 맥이나 CPU만 있는 환경에서 같은 방식으로 바로 실행된다고 가정하면 안 됩니다.
회의나 상담 녹음에서 최종 목표가 “화자별 대화록”이라면 이 모델 하나로 끝나는 것이 아니라, Nemotron 3 Diarization으로 화자 구간을 만든 뒤 ASR의 단어 타임스탬프를 결합하는 구조가 맞습니다. 반대로 이미 전사 모델이 있고 여러 명이 겹쳐 말할 때 화자 배정이 약한 파이프라인이라면 이번 모델이 맡을 자리가 분명합니다.


